最近翻到一张旧照片,是蚂蚁财富工区里挂过的“财富编码军规”海报。离开几年后再看,很多具体系统已经变化,但海报里的并发、幂等、资金核对、生产变更和应急原则并没有显得过时。
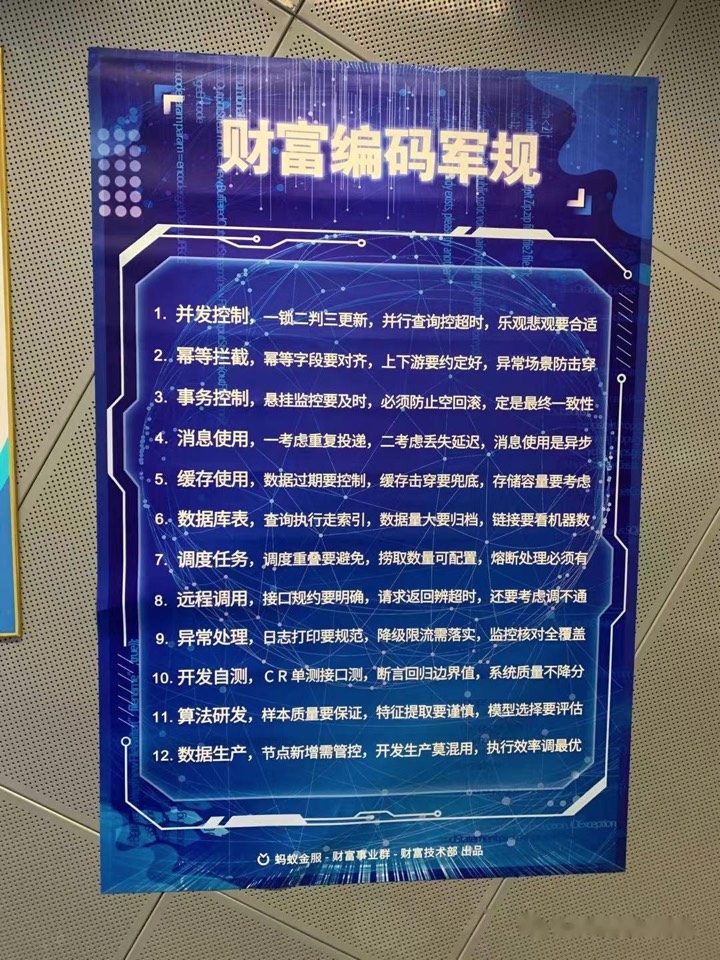
财富技术部的编码军规海报
我当时做过基金养老业务的 QA Owner,也参与过个人养老金项目。下面不是对内部规范的完整解释,只是结合那段经历,记录几条对我影响较深的做法。文中提到的系统名和流程是当时的工作记忆,不代表今天仍然相同。
一锁二判三更新
这句话容易被记成固定模板:加锁、检查状态、更新数据。真正落地时,还要继续问:
- 锁住的是一行、一个范围,还是意外锁住大量数据;
- 查询是否命中合适索引;
- 判断条件是否覆盖重复请求和状态变化;
- 事务里是否包含慢 RPC 或其它不确定操作;
- 超时、回滚和重试后状态是否仍然一致。
测试也不能只验证单请求成功。至少要覆盖并发提交、重复提交、乱序回调、超时重试和部分失败。
后来做无人车任务下发时,我仍然会问类似问题:同一条指令重复到达会不会产生第二次副作用,旧状态的回调会不会覆盖新状态。业务不同,状态机和并发控制的基本问题很接近。
幂等不是“接口多传一个 key”
幂等键只是入口。完整的幂等设计还包括:
- 键的业务范围和有效期;
- 相同键、不同参数如何处理;
- 请求处理中再次到达时返回什么;
- 第一次执行结果未知时能否安全重试;
- 跨系统调用时如何保持同一业务标识;
- 幂等记录与真实业务状态如何核对。
如果调用方超时,但服务端实际上已经成功,下一次请求最容易暴露设计是否完整。这个场景在资金业务、订单系统和车云指令里都很常见。
金额要带上币种和单位
金融系统里,金额不应只是一段浮点数。至少要明确:
- 币种;
- 精确值;
- 单位是元、分还是其它最小单位;
- 舍入规则;
- 展示值和账务值的关系。
这类要求看起来基础,跨系统后却很容易出现一边按元、一边按分,或者不同环节舍入方式不一致。
代码层应使用适合十进制金额的类型和统一 Money 对象,接口、数据库、消息和前端也要保持同一语义。测试重点不是只验一个正确样例,而是验精度边界、负数、退款、拆分合并和多次计算。
核对不是上线前的一次检查
我在基金养老业务里逐渐理解的一件事是:测试通过只能说明发布前的已知场景,线上资金状态仍然需要持续核对。
核对通常包括:
- 业务流水与账务流水;
- 账户余额与明细;
- 上下游状态;
- 过程账户的流入流出;
- 最终份额或结果与用户展示。
出现差异时,还要能区分延迟、在途、重复、漏单和真实资金错误。没有清晰的差异分类,告警很快会变成没人敢处理的噪音。
现在做车云链路,我也会关注任务下发、车端执行和云端回传是否一致。这不是资金对账,但“多个系统各自记录同一事实”的问题相似。
变更要可观察、可停止、可回退
财富军规里关于生产变更的要求,我后来在不同公司都见到过相近版本:
- 提前说明范围和风险;
- 分批灰度;
- 变更前检查容量、依赖和回滚条件;
- 变更中观察关键指标;
- 出现异常时先停止扩大影响;
- 变更后继续观察,而不是发布结束就散场。
这些动作并不复杂,难的是在进度紧张时仍然执行。
我参加过双 11 值班。印象最深的不是某条峰值曲线,而是每项操作都有 owner、监控和应急预案,重要配置要复核,异常时有明确的沟通链路。
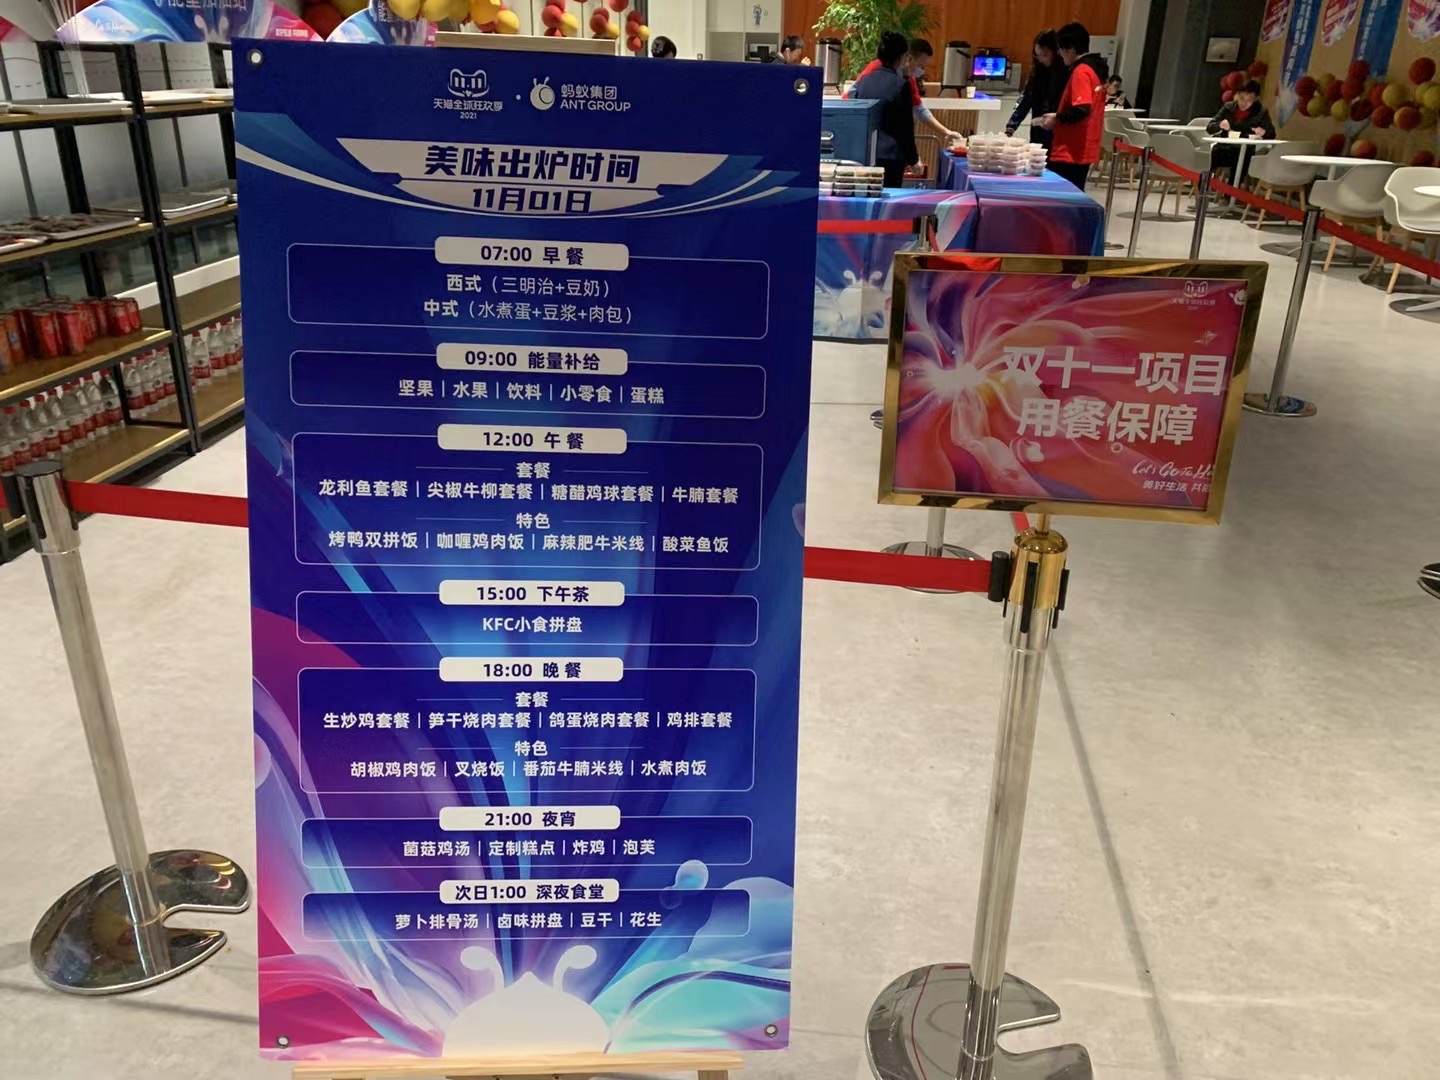
大型活动会把平时分散的容量、监控、应急和协作问题集中暴露出来。更重要的是把这些做法带回日常发布,而不是只在大促前临时加强。
应急操作需要复核
故障发生时,工程师最容易因为压力而缩短思考。涉及资金、权限、批量数据或车辆控制的操作,双人复核并不是拖慢效率,而是在防止第二次事故。
我会重点确认:
- 当前目标是止血、恢复还是订正数据;
- 操作影响哪些用户和系统;
- 是否可逆;
- 执行前后的核对方式;
- 谁审批、谁执行、谁观察;
- 必要时是否需要业务或客服参与。
应急结束后还要补齐记录和长期修复。只恢复服务但没有解释数据状态,问题并没有真正结束。
中间件名称会变,故障模式不会完全变
当时接触过 Tair、OceanBase、SOFA 体系、分布式事务和多地容灾等内部基础设施。刚开始确实需要花时间学习,但后来更有用的不是记住所有产品名,而是理解它们解决的问题:
- 主备切换期间请求会怎样;
- 缓存和数据库不一致如何发现;
- 消息重复、乱序和积压如何处理;
- 分布式事务的中间状态如何恢复;
- 限流、熔断和降级是否真的生效;
- 监控能否在用户反馈前发现异常。
换到新的公司和技术栈后,这些问题仍然存在,只是实现不同。
几年后的回看
海报上的条目并不会自动让系统可靠。真正有用的是把它们落到代码评审、测试设计、发布流程和线上核对里,并且在业务变化后持续修订。
对我影响较大的几条,可以归纳为:
- 并发更新要同时检查锁范围和状态机;
- 幂等要覆盖结果未知和跨系统链路;
- 金额、状态和权限必须有统一语义;
- 核对是在线系统的一部分;
- 重要变更要灰度、观察和可回退;
- 高风险应急操作要复核。
这些做法不只属于金融。只要一个系统的错误会真实影响用户,它们就值得保留。